Skip to content

Murali Krishna Marimekala

  • Home
  • MBA
    • Leadership Skills
    • Strategy formulation
    • Problem Solving
    • Frameworks
  • Artificial Intelligence
    • Data Science
    • Deep Learning
    • Machine Learning
  • WiFi
  • About Me
  • Deep Learning
  • Machine Learning
  • Generative AI

Tag: Long Context

  • Home
  • Long Context
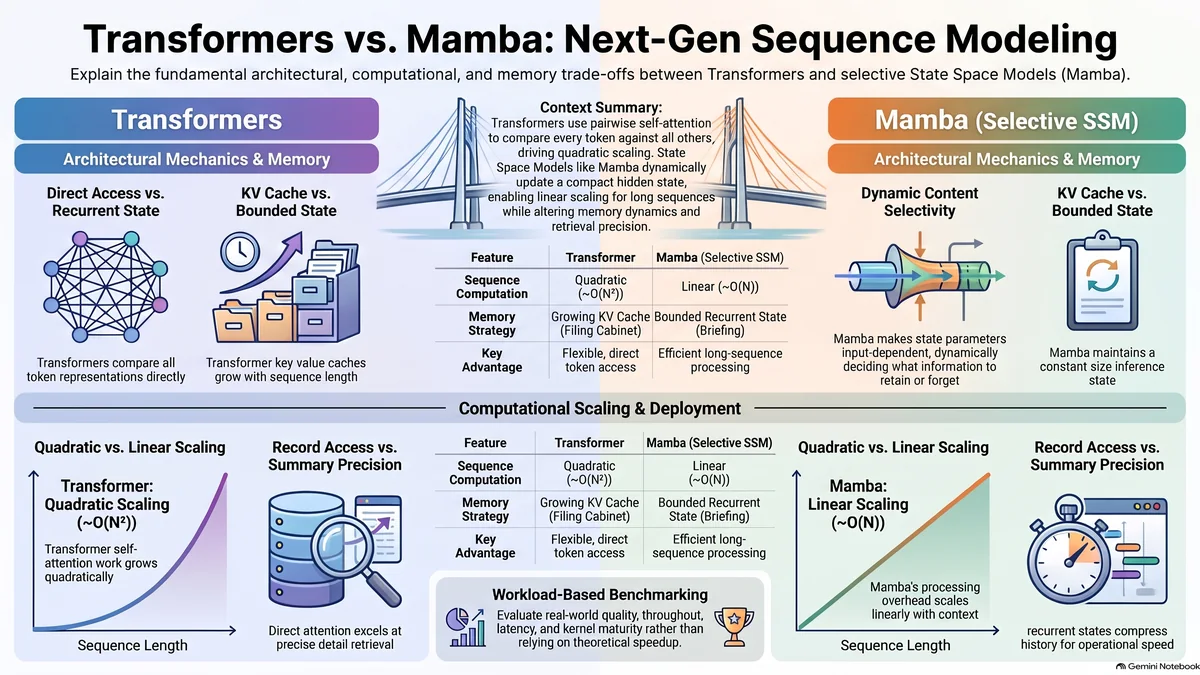
Infographic comparing Transformer attention and Mamba selective state space models, including sequence scaling and memory trade-offs.
Artificial Intelligence Deep Learning Generative AI Technology Leadership

State Space Models and Mamba: Rethinking Sequence Modeling

Learn how State Space Models and Mamba process sequences, why their linear-time design challenges Transformer attention, and what leaders should know about trade-offs.

November 22, 2026


  • State Space Models and Mamba: Rethinking Sequence Modeling
  • Mixture of Experts (MoE): Routing, Sparse Activation, and Why Modern Frontier Models Use It
  • Autoregressive Generation: Commanding AI Output for Strategic Business Advantage
  • Advanced Transformer Architectures & LLM Mechanics: Beyond Vanilla Transformers – Strategic Imperatives for the C-Suite
  • Scaling Laws: Why “Bigger” Isn’t Always Blindly Better in AI, and What Chinchilla Taught Us
  • November 2026
  • October 2026
  • September 2026
  • August 2026
  • July 2026
  • June 2026
  • May 2026
  • April 2026
  • March 2026
  • February 2026
  • January 2026
  • December 2025
  • November 2025
  • October 2025
  • September 2025
  • August 2025
  • July 2025
  • June 2025
  • May 2025
  • April 2025
  • March 2025
  • February 2025
  • January 2025
  • December 2024
  • October 2024
  • August 2024
  • July 2024
  • June 2024
  • May 2024
  • March 2024
  • February 2024
  • December 2023
  • November 2023
  • October 2023
  • September 2023
  • August 2023
  • July 2023
  • June 2023
  • May 2023
  • April 2023
All Rights Reserved 2026.
Proudly powered by WordPress | Theme: Palawan by Candid Themes.